
Рабочий алгоритм для CTO и инфраструктурного архитектора: пять факторов, по которым собираются требования к серверу для локального инференса LLM, — прежде чем открывать спецификацию GPU.
С чего начинается выбор и почему первый шаг обычно неверный
Разговор про сервер для LLM в компании часто начинается одинаково: «Какой GPU нам купить?». Иногда с готовой конфигурацией на руках: коллеги посоветовали, вендор прислал спецификацию, попался разбор в блоге. И вопрос уже не «нужен ли нам сервер для запуска LLM», а «этот подойдёт или взять помощнее?».
Проблема не в конкретной конфигурации, а в порядке шагов. Выбор оборудования это последний шаг, а не первый. До обсуждения GPU, VRAM и PCIe компании стоит ответить на четыре вопроса. Какую задачу будет решать модель. Сколько пользователей будут работать одновременно. Какие требования к скорости ответа. Как эта нагрузка изменится через год-два. Только после этого разговор про сервер для инференса LLM становится содержательным: появляются цифры, к которым прикладывают характеристики железа.
Материал продолжает статью про облако, гибрид или собственный контур AI-инфраструктуры. Если решение о запуске LLM на своём железе уже принято, ниже рабочий алгоритм. Пять факторов; по каждому: что нужно собрать, зачем он влияет на выбор и во что превращается в характеристиках оборудования.
Как думать о конфигурации: пять факторов
Инференс (inference) LLM, это использование обученной языковой модели для ответов на запросы пользователей. Проще говоря, модель уже готова, задача сервера в том, чтобы быстро отвечать. Под эту задачу и собирается локальная конфигурация сервера для ИИ.
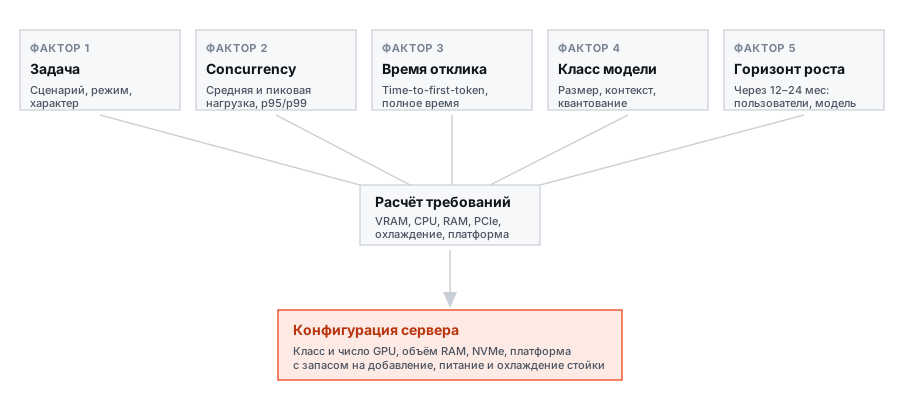
1. Задача
С чего начать сбор данных
Тип сценария: внутренний корпоративный ИИ-ассистент по документации, суммаризация длинных текстов, поиск по внутренней базе, code-помощник в IDE, классификация обращений, автоматизация процессов. Режим работы: интерактивный (пользователь ждёт ответ) или пакетный (задачи обрабатываются в фоне). Характер: генерация нового текста или анализ существующего.
Почему это влияет на всё остальное
Тип задачи задаёт профиль нагрузки и требования к отклику. Внутренний корпоративный ИИ-ассистент хочет коротких пауз до первого слова. Пакетной обработке тысячи документов не важно ничего, кроме максимальной пропускной способности. На одном сервере можно уместить оба сценария, но железо в этом случае считается под самый жёсткий.
Что это даёт при выборе оборудования
Определяется стратегия батчинга (объединение запросов в группы для эффективной работы GPU) и приоритет параметров карты. Интерактивные сценарии выигрывают от быстрой памяти GPU и небольших батчей. Пакетные выигрывают от максимальной пропускной способности и крупных батчей.
2. Concurrency
Какие данные нужны
Среднее и пиковое количество одновременных запросов и есть concurrency (одновременность). Профиль распределения нагрузки в течение суток и недели. Целевые квантили задержки, которые сервер должен держать под пиком: обычно p95 или p99 (то есть задержка, в которую укладывается 95 или 99 запросов из 100).
Почему без этой цифры собирать сервер нельзя
Один сотрудник, задающий вопрос раз в минуту, и сто пользователей в параллель, это два принципиально разных сервера. Concurrency при инференсе LLM, это количество одновременных запросов, которое сервер обрабатывает без ухудшения времени отклика. Пиковая нагрузка задаёт нижний предел мощности, средняя нагрузка задаёт экономику эксплуатации.
Как concurrency превращается в железо
Количество и класс GPU. Объём CPU-ядер: типовой ориентир 16–32 современных ядра на один GPU при умеренной нагрузке, при высокой параллельности заметно больше. Объём RAM: типовой ориентир в 2–3 раза больше суммарного VRAM (под загрузку и переключение моделей, кэши, работу ОС). Слабый CPU в упор к сильным GPU регулярно становится бутылочным горлышком: экономия здесь окупается медленной работой всего сервера.
3. Время отклика
Что зафиксировать до расчёта
Целевая задержка первого токена (time-to-first-token), время, за которое модель начинает отвечать. Допустимое полное время генерации ответа. Квантиль, на который смотрим: p50 показывает типичный ответ, p95 и p99 показывают гарантию под нагрузкой.
Почему это ощущается пользователем сильнее всего
Задержка первого токена определяет ощущение «работает быстро». Для интерактивного ассистента пауза больше 1–2 секунд читается как «зависло», даже если полный ответ придёт за приемлемое время. Для фонового пайплайна суммаризации задержка первого токена значения не имеет, важно только полное время.
Как задержка транслируется в характеристики
Класс GPU по скорости памяти важнее чистой вычислительной мощности для инференса. Стратегия батчинга: меньший батч даёт меньшую задержку, но и меньшую пропускную способность (throughput). Компромисс выбирается под сценарий. Оптимизации стека инференса (спекулятивное декодирование, KV-cache и другие) позволяют выжать больше запросов из того же железа, но требуют дополнительной VRAM.
4. Класс модели
Что зафиксировать
Класс модели, которую планируется использовать: малая (единицы миллиардов параметров), средняя (десятки миллиардов), большая (сотни миллиардов). Ожидаемая длина контекста в среднем и в предельных случаях. Планы на квантование (INT8, INT4) или сохранение исходного FP16.
Почему класс модели это точка перехода к железу
Он напрямую задаёт объём VRAM (video RAM, оперативная память GPU). Модель должна поместиться в VRAM целиком, иначе она либо не запустится, либо будет работать через выгрузку в обычную оперативную память с многократной потерей скорости. Типовые ориентиры без квантования: малая модель 8–16 ГБ VRAM, средняя 24–48 ГБ, большая от 80 ГБ. Квантование (сжатие весов модели до меньшей битности) в INT8 сокращает потребление VRAM примерно вдвое относительно FP16, INT4 сокращает ещё вдвое. Для многих корпоративных задач INT8/INT4 приемлемы; для критичных сценариев вроде юридического ассистента или работы с точной терминологией деградацию тестируют на своих данных.
Во что превращается класс модели в железе
Класс и количество GPU (для большой модели встаёт вопрос multi-GPU, см. FAQ). Объём NVMe: минимум под несколько версий модели и логи, типовой ориентир 2 ТБ. PCIe как шина между CPU и GPU: Gen4 x16 приемлемо для большинства задач, Gen5 x16 даёт запас на большие модели.
5. Горизонт роста
Что оценить
Ожидаемое количество пользователей через 12 и 24 месяца. Класс модели, к которому планируется переходить: расширение сценариев, повышение качества ответов, работа с более длинным контекстом. Сценарий развития: расширяем ассистента, добавляем новые задачи, растёт компания.
Почему запас не роскошь, а исходное требование
Сервер, выбранный «в упор» под сегодняшнюю нагрузку, через год окажется тесен, и вопрос про сервер для запуска LLM придётся решать заново. Апгрейд платформы, изначально не рассчитанной на расширение, обходится дороже правильно выбранной платформы с запасом.
Как горизонт формирует спецификацию
Выбор платформы с возможностью добавлять GPU и RAM, а не «полный корпус на старте». Запас по питанию и охлаждению стойки: типовой корпоративный GPU выделяет 300–700 Вт тепла, сервер на 4 GPU уже даёт 2–3 кВт в стойке. Воздушное охлаждение работает до определённого порога, дальше жидкостное. Питание и охлаждение обсуждаются на этапе выбора оборудования, не после монтажа.
Что делать дальше
Соберите входные данные по пяти факторам выше и передайте нам вместе с описанием бизнес-задачи. На их основе мы сделаем предварительную экспертную оценку требований и возможной конфигурации сервера для инференса LLM. Это не КП с ценой, а разбор, из которого видно порядок величин, ключевые ограничения и разумные варианты платформы. Дальше вы принимаете обоснованное решение по железу.