
Как выбрать GPU-сервер для обучения нейросетей и fine-tuning: пять параметров задачи, требования к VRAM, CPU, памяти, storage, интерконнекту между GPU. Фреймворк для ML-инженера и IT-архитектора.
Почему тот же сервер, что для инференса, не подойдёт для обучения
Разговор про GPU-сервер для обучения часто идёт по инерции от инференса. Компания уже подобрала конфигурацию под запуск готовой модели, ML-команда просит «такой же, только помощнее», и через две недели после закупки на первом же прогоне обучение падает с out-of-memory на модели, которая при инференсе спокойно помещалась в те же карты.
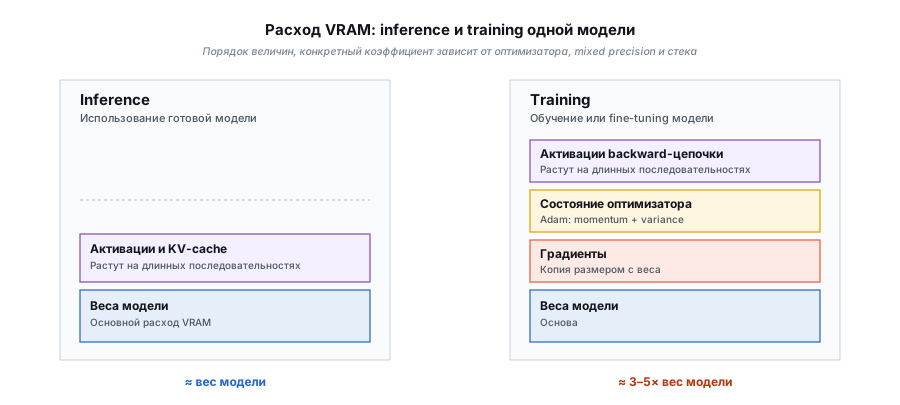
Причина в том, что обучение и инференс тратят VRAM принципиально по-разному. При инференсе основной расход VRAM: веса модели, к которым добавляются активации и KV-cache для генерации (заметно растёт при длинном контексте). При обучении к весам добавляются градиенты, состояние оптимизатора и промежуточные активации всей backward-цепочки. Для оптимизаторов класса Adam потребление VRAM при обучении обычно кратно выше, чем при инференсе той же модели. Точный коэффициент зависит от оптимизатора, применения mixed precision и техник вроде gradient checkpointing.
И это только один из четырёх принципиальных отличий. Обучение требует непрерывного обмена данными между GPU на каждой итерации, поэтому наличие быстрого внутрихостового интерконнекта становится критичным критерием выбора платформы. Обучение читает и пишет большие объёмы датасета, поэтому пропускная способность storage-пайплайна влияет на утилизацию GPU. Обучение работает в упор длительное время, поэтому питание и охлаждение стойки считаются с запасом.
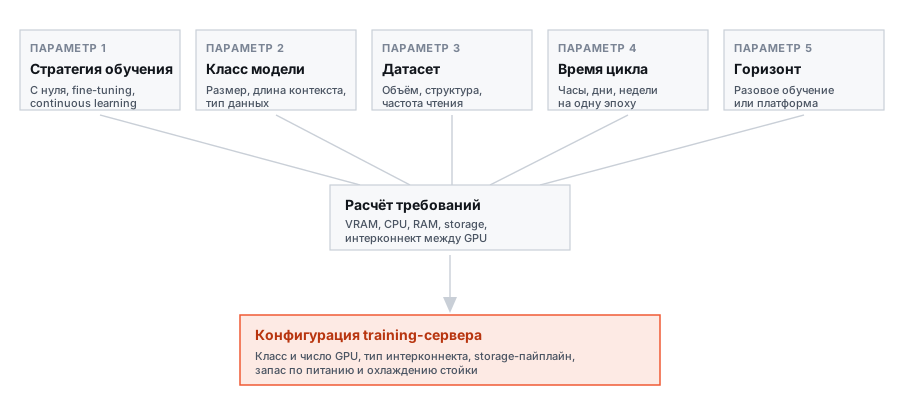
Материал продолжает статью про сервер для инференса LLM. Если нужен только inference, ответ там. Если задача касается обучения или дообучения моделей у себя, ниже рабочий алгоритм. Пять параметров задачи, по каждому: что собрать, зачем он влияет на конфигурацию сервера и во что превращается в железе.
Как думать о конфигурации: пять параметров задачи
Обучение модели: это процесс, при котором нейросеть последовательно проходит по датасету и обновляет свои веса на каждой итерации, чтобы минимизировать ошибку на целевой задаче. От инференса отличается тем, что здесь модель не отвечает пользователю, а сама учится.
Одна общая оговорка ко всем пунктам ниже. Приведённые диапазоны служат типовыми ориентирами, а не универсальными требованиями. Их задача: задать порядок величин в разговоре о конфигурации. Реальный расчёт зависит от четырёх переменных: конкретной модели и её архитектуры, размера батча и стратегии оптимизации, объёма и структуры датасета, программного стека и уровня оптимизации обучения. Под конкретный проект каждый диапазон уточняется, здесь он нужен только чтобы обозначить масштаб.
1. Стратегия обучения
С чего начать сбор данных. Что делаем: обучение с нуля (from scratch), fine-tuning готовой модели, continuous learning (постоянное дообучение под новые данные). Готовая модель как отправная точка или полностью своя архитектура. Тип данных: текст, изображения, мультимодальные (текст + картинки, видео).
Почему это первый вопрос. Обучение с нуля требует полного цикла: инициализация весов, backpropagation через всю модель, оптимизация под минимизацию функции потерь. Fine-tuning работает с уже подготовленной моделью, обычно требует в разы меньше данных и меньше VRAM (особенно при использовании техник LoRA или PEFT, где обучаются только небольшие адаптеры). Continuous learning: периодическое дообучение под свежие данные, обычно на подмножестве полного датасета.
Как это транслируется в железо. Обучение с нуля крупных моделей обычно требует multi-GPU конфигурации, часто multi-node; конкретный масштаб зависит от размера модели, длины контекста, стратегии оптимизации, целевого времени цикла и стека. Fine-tuning средних моделей часто закрывается в рамках одного сервера, но диапазон конфигураций широкий. Continuous learning считается под самый требовательный из плановых циклов, с запасом. Универсальной формулы «сценарий → количество GPU» нет, конфигурация подбирается под задачу.
2. Размер и класс модели
Что зафиксировать. Число параметров модели: малая (сотни миллионов до единиц миллиардов), средняя (десятки миллиардов), большая (сотни миллиардов и больше). Длина контекста, если модель работает с последовательностями (важно для языковых моделей и трансформеров с длинным контекстом). Тип данных на входе (влияет на объём активаций).
Почему класс модели служит точкой входа в VRAM-расчёт. Он задаёт объём памяти под веса, градиенты и состояние оптимизатора. Расход VRAM при обучении с оптимизатором Adam обычно кратно превышает вес модели во время инференса; конкретный коэффициент зависит от типа оптимизатора, применения mixed precision, техник вроде gradient checkpointing, размера батча. Плюс активации всей backward-цепочки, которые могут заметно вырасти на длинных последовательностях.
Во что превращается в железо. Прямой формулы «класс модели → фиксированное количество GPU» не существует: одна и та же модель может обучаться на 2 картах с оптимизациями, на 8 картах в комфорте или на кластере в multi-node. Конкретный масштаб определяется сочетанием размера модели, длины контекста, размера батча, стратегии оптимизации (mixed precision, gradient checkpointing, LoRA/PEFT), целевого времени цикла и стека. На практике: малые модели часто закрываются несколькими GPU в одном сервере; средние: до полного 8-GPU сервера с быстрым интерконнектом; большие обычно требуют multi-node. Итоговая конфигурация под конкретный проект считается на этапе предварительной оценки требований.
3. Объём и профиль датасета
Какие данные нужны. Общий объём датасета в гигабайтах или терабайтах. Тип файлов и структура (сплошной текст, множество мелких файлов, изображения высокого разрешения). Как часто датасет читается за один цикл обучения (эпоху). Планируется ли перегенерация датасета между эпохами (data augmentation).
Почему датасет влияет на выбор сервера, а не только на диски. GPU при обучении потребляют данные быстрее, чем стандартная корпоративная СХД их отдаёт. Если storage-пайплайн не успевает загружать следующий батч, GPU простаивают в ожидании данных, а стоимость топовых GPU высокая. Экономия на дисках и storage-пайплайне на training-сервере обычно приводит к падению утилизации GPU и потере эффективности инвестиций в дорогое железо.
Что это даёт при выборе железа. Требования к дискам зависят от профиля нагрузки: при интенсивном I/O между storage и GPU обычно применяют NVMe с прямым PCIe-доступом; для сценариев с умеренной интенсивностью подходят SAS/SATA SSD или сетевой storage. Объём: под 1–2 полные копии активного датасета плюс checkpoint-хранилище на несколько промежуточных состояний обучения. Точные диапазоны сильно зависят от типа данных и размера датасета; типовые сценарии считаются под конкретный проект. Для больших датасетов и распределённого обучения storage-архитектура выносится за пределы одного сервера и разбирается в статье про техническую архитектуру AI-инфраструктуры.
4. Целевое время цикла
Что зафиксировать до расчёта. Сколько должно занимать одно полное обучение (эпоха или полный цикл на всём датасете): часы, дни, недели. Приемлемо ли, что цикл растягивается на месяцы для очень больших моделей. Сколько итераций обучения планируется за квартал (влияет на economics: cost per training run).
Почему это меняет требования к железу. Одна и та же модель может обучаться на одной конфигурации в разы дольше, чем на другой, а вместе со скоростью растут требования к интерконнекту между GPU, storage-пропускной способности, инженерной инфраструктуре стойки, размеру команды сопровождения. Универсального соотношения «время → количество GPU» нет; оно зависит от размера модели, объёма датасета, длины контекста, оптимизации стека.
Как это транслируется в конфигурацию. Более сжатый бюджет времени обычно транслируется в большее количество GPU в сервере или в переход к multi-node. Multi-node обучение требует межхостовой сети высокой пропускной способности и планирования инженерной инфраструктуры под непрерывную работу. Конкретный масштаб конфигурации под целевое время подбирается на этапе оценки: универсальной таблицы «часы / дни / недели → фиксированное количество серверов» не бывает, слишком много переменных.
5. Горизонт использования сервера
Что оценить. Разовое обучение под конкретный проект или платформа под непрерывное развитие моделей на 3–5 лет. План по добавлению новых сценариев обучения через год-два. Кто и как эксплуатирует сервер: одна команда data science / MLOps как shared-resource для нескольких команд / production training как услуга для внешних заказчиков.
Почему горизонт формирует стратегию покупки. Сервер, выбранный «в упор» под сегодняшний сценарий обучения, через год оказывается тесен, и вопрос про инфраструктуру для обучения возникает заново с новым бюджетом. GPU-серверы дорогие, замена платформы через 12–18 месяцев обычно экономически нецелесообразна. Разумно выбирать платформу с запасом по слотам GPU и питанию стойки.
Как это влияет на выбор конфигурации. Платформа с возможностью добавлять GPU без замены шасси. Стойка с запасом по мощности и охлаждению под целевой рост. Тепловыделение современных корпоративных GPU для обучения составляет сотни ватт на карту, суммарная нагрузка сервера с 4–8 GPU часто превышает возможности стандартной корпоративной серверной стойки. Инженерная архитектура под растущий контур (жидкостное охлаждение, RDHx, immersion): тема отдельной статьи про техническую архитектуру AI-инфраструктуры.
VRAM: главное отличие от инференса
При выборе сервера под обучение стоит помнить общую логику: при обучении с оптимизатором Adam расход VRAM обычно кратно превышает вес модели в формате fp16, потому что в памяти одновременно живут веса, градиенты и momentum-состояния оптимизатора. Плюс активации всей backward-цепочки, которые растут на длинных последовательностях. Точный коэффициент зависит от оптимизатора, mixed precision, gradient checkpointing, размера батча; универсальной формулы нет.
Типовые ориентиры по классам моделей без применения оптимизаций: малые модели чаще закрываются одним-двумя GPU корпоративного класса; средние: до 8-GPU конфигурации в одном сервере; большие обычно требуют multi-node. Реальные диапазоны сильно зависят от применённых оптимизаций и стека, стоит рассматривать не как «правило», а как порядок величин для стартового разговора.
Что делать, когда модель не помещается в один GPU:
- Mixed precision (fp16, bf16, fp8) сокращает расход VRAM без критической потери качества для многих сценариев. Точный эффект зависит от модели и стека, для критичных задач деградацию проверяют на своих данных.
- Gradient checkpointing: перерасчёт активаций во время backward pass вместо хранения в памяти. Компромисс: расход VRAM снижается, время обучения растёт; точные показатели зависят от модели и размера батча.
- Multi-GPU с разбивкой модели: если модель не помещается даже с оптимизациями, применяются техники параллелизма (data parallelism, model parallelism, tensor parallelism). Требуют качественного интерконнекта между картами (см. раздел про интерконнект).
CPU, RAM, storage под training
CPU. Обучение выглядит как GPU-задача, но CPU занимается data pipeline: чтение датасета с диска, декодирование, аугментации, tokenization для текстов, resize и normalize для изображений. Слабый CPU становится бутылочным горлышком: GPU простаивают в ожидании подготовленного батча. Требуемое количество ядер зависит от типа данных, тяжести аугментаций и стека: тяжёлый препроцессинг (обработка видео, сложные аугментации изображений) обычно требует заметно больше CPU-ресурсов на GPU, чем базовая обработка текста.
RAM. Общий принцип: RAM должно быть достаточно для кэширования части датасета и служебных структур обучения. Соотношение с суммарным VRAM в системе служит типовым ориентиром для стартового расчёта, но реальный объём зависит от размера рабочего датасета, стека и режима эксплуатации.
Storage под датасет. Требования зависят от профиля нагрузки: для типовых training-сценариев с интенсивным I/O между storage и GPU обычно применяют NVMe с прямым PCIe-доступом. Для случаев, где датасет умещается в RAM или загружается редко, локальные SAS/SATA SSD или сетевой storage могут быть достаточны. Объём: под 1–2 полные копии активного датасета плюс место для промежуточных checkpoint. Требования к пропускной способности сильно зависят от типа данных, размера батча и оптимизации data pipeline; детали расчёта под конкретный сценарий делаем на этапе подбора конфигурации. Полноценная архитектура storage для больших датасетов и распределённого обучения (parallel filesystem, object storage tier): тема отдельного разбора в статье про техническую архитектуру AI-инфраструктуры.
Storage под checkpoints и результаты. Отдельный том, обычно на менее быстрых дисках. Объём: под несколько промежуточных состояний модели плюс итоговые версии.
Интерконнект между GPU: что учесть при выборе платформы
При multi-GPU обучении каждая итерация сопровождается обменом данными между картами: как минимум для синхронизации градиентов, а при model parallelism ещё и промежуточных активаций. Пропускная способность интерконнекта между GPU определяет, какую долю времени карты реально считают, а не ждут данные от соседей.
Требования к интерконнекту при выборе платформы определяются профилем обмена, а не просто числом GPU:
- Data parallelism на небольших моделях с длинными вычислительными шагами. Синхронизация нечастая, стандартные внутрихостовые соединения через материнскую плату часто закрывают задачу без заметного простоя.
- Data parallelism на моделях с частой синхронизацией или большими градиентами. Обычные внутрихостовые линии становятся узким местом; выигрыш от специализированных высокоскоростных соединений между картами (NVLink и NVSwitch у NVIDIA, XGMI у AMD) заметный, часто без них 8 карт не дают ожидаемого ускорения относительно 4.
- Model parallelism или tensor parallelism (модель распределена по нескольким GPU одного сервера). Пропускная способность интерконнекта критична: активации передаются между картами на каждом шаге прямого и обратного прохода, узкий интерконнект приводит к простою карт независимо от их производительности.
- Multi-node обучение. Это уже уровень инфраструктуры вокруг серверов: межхостовая сеть с высокой пропускной способностью, отдельная топология, storage. Конкретный fabric выбирается от масштаба кластера и целевой эффективности, не универсальным правилом, а расчётом под задачу. Разбор в статье про техническую архитектуру AI-инфраструктуры.
Требования к стойке: что учесть при выборе платформы
GPU-сервер для обучения работает под высокой нагрузкой длительное время; это отличается от типового корпоративного сервера с умеренной средней утилизацией.
Тепловыделение современного корпоративного GPU для обучения составляет сотни ватт на одну карту. Сервер с 4–8 GPU может давать существенную постоянную тепловую нагрузку, которая часто превышает возможности стандартной корпоративной серверной стойки.
Что это означает при выборе платформы:
- Проверить проектные ограничения стойки, куда планируется поставить сервер: доступная мощность, тип охлаждения, свободные линии питания.
- Заложить запас по питанию: с двойным вводом на разные линии для отказоустойчивости.
- Согласовать способ охлаждения: воздушное усиленное, Rear Door Heat Exchanger, direct-to-chip или immersion зависит от плотности планируемой конфигурации.
Полноценный разбор инженерной архитектуры под AI-нагрузки (типы охлаждения, схемы питания, резервирование, стандарты): в отдельной статье про техническую архитектуру AI-инфраструктуры.
Что делать дальше
Соберите входные данные по пяти параметрам выше и передайте нам вместе с описанием бизнес-задачи. На их основе мы сделаем предварительную экспертную оценку требований и возможной конфигурации сервера для обучения. Это не КП с ценой, а разбор, из которого видно порядок величин, ключевые ограничения по железу и стойке, разумные варианты платформы.
Если решение о локальном обучении ещё не принято окончательно, начните со статьи про облако, гибрид и собственную AI-инфраструктуру. Если нужен только инференс готовой модели, у нас есть отдельный материал про сервер для запуска LLM. Если задача понятна и нужно посмотреть, из чего собираются такие серверы, см. серверы для бизнеса от Инком интер.