
Как собрать AI-инфраструктуру: пять инфраструктурных уровней (compute, сеть, СХД, питание, охлаждение), типовые ошибки проектирования, разбор архитектуры под training и inference-нагрузки. Гайд для IT-архитектора и руководителя ЦОД.
Три типовых риска, которые возникают в AI-проектах
Есть три сценария, которые повторяются в проектах и хорошо описывают, почему AI-инфраструктура складывается не только из «купить серверы с GPU»:
- Тепловая нагрузка вышла за возможности стойки. GPU-серверы работают под нагрузкой длительное время, суммарное тепловыделение выше стандартного корпоративного профиля. Если стойка не рассчитана на такую плотность, серверы могут снижать частоту при перегреве и в итоге не давать ожидаемой производительности.
- Сеть между GPU-серверами не тянет обмен градиентами. При распределённом обучении GPU обмениваются данными на каждой итерации через межхостовую сеть. Если её пропускная способность или задержки не соответствуют профилю нагрузки, GPU простаивают в ожидании синхронизации, а эффективность кластера падает.
- Storage-пайплайн не успевает за GPU. GPU при обучении и в ряде inference-сценариев требуют высокой пропускной способности storage. Обычная корпоративная СХД, спроектированная под IOPS для баз данных, часто не даёт нужного sustained-throughput, и карты простаивают в ожидании данных.
Общее у трёх рисков одно: слабое звено вне сервера ломает утилизацию топового железа. AI-нагрузка проверяет всё, что стоит вокруг GPU: сеть между серверами, storage под датасеты, питание стойки, охлаждение зала.
Материал разбирает пять уровней AI-инфраструктуры и типовые ошибки на каждом. Если ещё не решён вопрос «облако или свой контур», начните со статьи про выбор между облаком, гибридом и собственной инфраструктурой. Если нужны требования к одному серверу (под инференс или под обучение), они разбираются отдельно.
Пять уровней AI-инфраструктуры
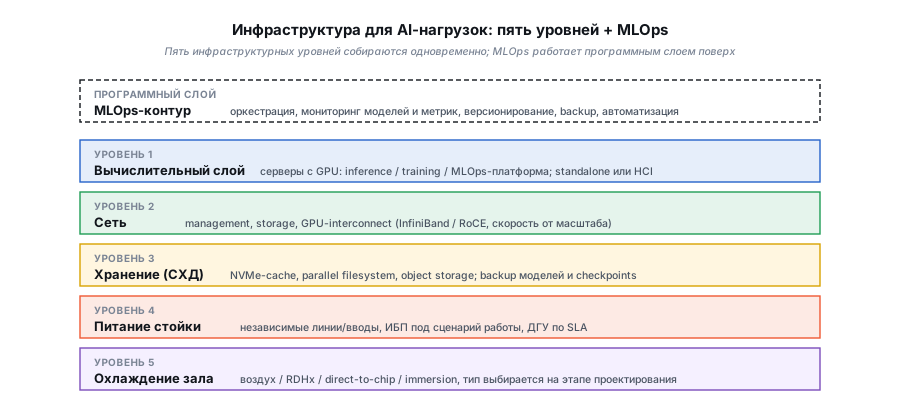
Инфраструктура для AI-нагрузок это согласованная система из пяти инфраструктурных уровней: вычислительный слой (серверы с GPU), сеть между ними, storage для данных и моделей, питание стойки, охлаждение зала. Каждый уровень должен быть рассчитан не на среднюю корпоративную нагрузку, а на профиль AI-задач: продолжительная работа под высокой нагрузкой, большие потоки данных, высокая плотность тепловыделения.
Поверх этих пяти уровней работает программный слой, MLOps-контур: оркестрация задач обучения и инференса, мониторинг моделей и метрик, версионирование, backup. MLOps это софт поверх инфраструктуры, а не отдельный шестой уровень; спроектировать его нужно синхронно с железом, но реализуется он как отдельная программная платформа.
Ошибка проектирования обычно возникает на границе между уровнями: серверы выбраны корректно, но сеть между ними не тянет обмен градиентами; storage быстрый, но питание стойки не рассчитано на нагрузку; охлаждение работает, но резервирования питания нет. Правильный подход: считать все пять уровней одновременно, с учётом целевой нагрузки, и планировать MLOps-контур на том же этапе.
Уровень 1. Вычислительный слой
Серверы под inference и серверы под training отличаются принципиально: разные конфигурации по профилю нагрузки: inference-сервер оптимизируется под быстрый отклик и переменную утилизацию, training-сервер работает под непрерывной высокой нагрузкой под высокой нагрузкой с интенсивным обменом данными между GPU и storage. Детали конкретных конфигураций разбираются в отдельных материалах: под inference и под training. MLOps-платформа поверх этих серверов даёт оркестрацию, мониторинг, версионирование моделей и датасетов, backup.
Плотность GPU в стойке зависит от целевой конфигурации и способа охлаждения зала: типичный ориентир составляет 4–8 GPU на сервер. Количество серверов в стойке определяется не универсальным правилом, а сочетанием проектной мощности стойки, типа охлаждения и допустимой плотности, конкретные диапазоны рассматриваются в разделе про охлаждение ниже.
Альтернатива стандартной 3-tier архитектуре (compute отдельно, storage отдельно). Альтернатива это гиперконвергентная инфраструктура (HCI), где compute и storage совмещены на одном узле. Выбор между HCI и 3-tier для AI-контура определяется несколькими качественными признаками: профилем нагрузки, требованиями по I/O, чувствительностью к latency, независимостью масштабирования compute и storage, совместимостью GPU и гипервизора. Разбор границ применимости и того, когда HCI подходит под AI, а когда лучше 3-tier, разобрано в отдельном разделе на нашей HCI-услуге.
Детали по конкретным конфигурациям одного сервера собраны в отдельных материалах: требования под inference, требования под training, сравнение вендорских платформ.
Уровень 2. Сеть для AI
Сеть в AI-кластере разделяется на три логических контура, которые не должны конкурировать за пропускную способность:
- Management-сеть: для управления серверами (IPMI, оркестрация, деплой конфигураций). Стандартный Ethernet 1–10 Гбит/с.
- Storage-сеть: для доступа GPU-серверов к общему хранилищу (parallel filesystem, object storage). 25–100 Гбит/с в зависимости от объёма storage-пайплайна.
- GPU-interconnect: для обмена градиентами и активациями при distributed training. Обычно InfiniBand или RoCE с высокой пропускной способностью; конкретная скорость выбирается от масштаба кластера и стратегии параллелизма.
Ключевой принцип: отсутствие конкуренции трафика между контурами. При distributed training GPU-interconnect должен работать без пересечения со storage- и management-трафиком: паразитная нагрузка приводит к простою GPU на синхронизациях градиентов. Логическое или физическое разделение контуров подбирается под проект: где-то это VLAN и QoS на одной инфраструктуре, где-то разные физические сети под каждый контур. Универсального правила «одна физическая сеть недопустима» нет; важен результат, а не способ реализации.
Технологии интерконнекта:
- InfiniBand HDR (200 Гбит/с per port) и NDR (400 Гбит/с per port): исторически стандарт для HPC и AI. Требует специализированного оборудования и обученной команды.
- RoCE (RDMA over Converged Ethernet): RDMA поверх Ethernet соответствующей пропускной способности. Часто ближе к корпоративным Ethernet-стандартам, требует настройки Priority Flow Control и корректной reference-implementation.
Конкретная скорость fabric выбирается от масштаба кластера, стратегии параллелизма и целевой эффективности. Небольшие кластеры на data parallelism с невысокой частотой синхронизации могут работать с меньшими скоростями; крупные training-кластеры с многоуровневым параллелизмом обычно требуют NDR или его аналогов.
Топология: для нескольких серверов в одной стойке часто достаточно leaf-switch. Для более крупных кластеров применяются leaf-spine или fat-tree топологии с полной bisection bandwidth.
Для inference-кластеров, где серверы работают независимо и не обмениваются градиентами, требования к сети ниже: типовой корпоративный Ethernet обычно закрывает задачу.
Уровень 3. Storage под AI
В AI-инфраструктуре хранятся три принципиально разных типа данных:
- Датасеты: большие объёмы (терабайты, для крупных проектов сотни ТБ и петабайты), read-heavy при обучении, потоковое чтение.
- Модели и веса: от гигабайтов до сотен ГБ на одну модель, часто пишутся один раз, много раз читаются при инференсе.
- Checkpoints: промежуточные состояния обучения, write-heavy, часто нужен fast writes с последующим редким чтением при восстановлении.
Требования к пропускной способности storage-пайплайна для training-сервера сильно зависят от типа модели, размера батча и стека; для одного training-сервера типичные значения ощутимы (единицы ГБ/с sustained read и выше), суммарно по кластеру доходит до десятков ГБ/с.
Типовая архитектура для крупного AI-контура:
- Быстрый NVMe-cache на самих серверах: под текущий рабочий батч датасета, самое горячее.
- Parallel filesystem (например, класс распределённых файловых систем на InfiniBand): под активный датасет для нескольких GPU-серверов одновременно.
- Object storage: под архив датасетов, редко используемые данные, backup моделей.
Выбор конкретной storage-архитектуры делается под профиль нагрузки, объём датасетов и распределение GPU-серверов, а не по универсальному правилу «столько-то серверов → parallel filesystem». Небольшие AI-контуры часто закрываются локальными дисками серверов и стандартной корпоративной СХД для backup. Parallel filesystem или другой tier общего storage становится оправданным, когда несколько training-серверов работают с одним активным датасетом или требуется общая суммарная пропускная способность выше того, что даёт локальный storage узлов.
Часто забываемый пункт: backup моделей и checkpoints. Обученная модель может стоить недели работы кластера, при потере восстановление невозможно. Backup модели и checkpoint-контрольных точек: обязательный элемент архитектуры, не «на потом».
Уровень 4. Питание
Топовый корпоративный GPU выделяет 700–1000 Вт TDP. Сервер на 8 GPU даёт 8–12 кВт постоянной нагрузки только на GPU, плюс 1–2 кВт на CPU, память и остальные компоненты.
Стойка с несколькими такими серверами быстро выходит на десятки кВт постоянного потребления. Для сравнения, типовая корпоративная серверная стойка традиционно проектировалась под 5–10 кВт (ASHRAE Datacom серия, историческая индустриальная плотность). AI-стойка требует принципиально другой инженерки; конкретная мощность рассчитывается под целевую конфигурацию.
Требования к электропитанию AI-стойки:
- Двойной ввод на разные фазы: при выходе из строя одной линии сервер продолжает работу через второй ввод, обучение не прерывается.
- PDU с балансировкой по фазам: равномерное распределение нагрузки, чтобы не выбить автомат при пиковых броскax.
- Резервирование через ИБП: обязательно, минимум на 5–10 минут для корректного завершения обучения и сохранения checkpoint при пропадании питания.
- ДГУ: оправдан для AI-контура, если недоступность даже на минуту критична (например, production-inference с SLA).
Потери на обучении при незапланированном отключении серьёзные: часы или дни работы кластера теряются, если checkpoint не был сохранён к моменту сбоя.
Уровень 5. Охлаждение
Тепловая нагрузка AI-стойки принципиально выше обычной корпоративной. Способ охлаждения выбирается в момент проектирования, «попробовать воздух и поставить жидкость потом» обычно не работает: жидкостное охлаждение требует перестройки инженерной инфраструктуры зала.
Основные типы охлаждения с ориентировочными диапазонами плотности стойки, при которой они обычно применимы. Конкретный порог зависит от проекта зала, типа стойки, температуры окружающей среды и допустимой ΔT:
- Стандартное воздушное: исторический ориентир до 6–10 кВт на стойку. Для inference-кластеров и MLOps-платформ обычно достаточно.
- Усиленное воздушное с in-row кондиционерами: типично до 12–15 кВт на стойку, при определённой топологии зала (hot/cold aisle). Реальный потолок зависит от проекта зала.
- Rear Door Heat Exchanger (RDHx): теплообменник на задней двери стойки с водяным контуром. Ориентировочно 15–25 кВт на стойку, часто применяется как апгрейд существующего зала под AI-нагрузку.
- Direct-to-chip liquid cooling: прямое охлаждение процессоров и GPU жидкостью. Обычно применяется на плотностях, где воздушное охлаждение перестаёт справляться (типично при 30+ кВт на стойку), реальные пороги зависят от проекта.
- Immersion cooling: сервера погружаются в диэлектрическую жидкость. Применяется на очень высоких плотностях (100+ кВт на стойку), пока используется в специализированных AI-кластерах.
При плотности выше 15–20 кВт воздушное охлаждение обычно перестаёт справляться, и в проекте начинают рассматривать жидкостные решения. Конкретный порог зависит от температуры окружающей среды в зале, топологии стойки и допустимой ΔT; универсального правила «выше N кВт обязательно жидкость» нет, точка перехода считается под конкретный проект.
Правило: тип охлаждения определяется на этапе проектирования зала, вместе с сервером и стойкой. Заменить воздушное охлаждение на жидкостное «через год после ввода» становится по факту новым инженерным проектом, не простой апгрейд.
Пять типовых ошибок при проектировании AI-инфраструктуры
-
Считать AI-инфраструктуру как обычную серверную. Плотность и тепловыделение принципиально другие, GPU работают под высокой нагрузкой длительное время. Инженерка, работавшая для корпоративных задач с типовой утилизацией, не тянет AI-профиль.
-
Экономить на сети между GPU-серверами. Дорогие GPU простаивают из-за узкой сети: при distributed training без соответствующего интерконнекта заметная доля времени уходит на синхронизации градиентов. Сэкономленный бюджет на сети выражается в переплате на GPU, которые не работают.
-
Использовать существующую СХД без проверки пропускной способности. Обычная enterprise-СХД проектировалась под IOPS для баз данных и не всегда тянет sustained-throughput, которого требует ML-workload. Серверы стоят, GPU ждут данные из storage.
-
Проектировать без запаса по питанию и охлаждению. Через год стойка не принимает ещё один сервер: питание в упор, охлаждение на пределе. Расширение AI-контура упирается в инженерку и требует пересчёта зала.
-
Игнорировать MLOps-контур на этапе проектирования. Инфраструктура работает, но команда не может её эксплуатировать: нет оркестрации задач обучения, мониторинга моделей, процедуры backup весов и checkpoints. MLOps это программный слой поверх пяти инфраструктурных уровней, но планировать его нужно синхронно с железом: он влияет на storage-архитектуру (объект-хранилище под артефакты), на сеть (доступ к оркестратору со всех узлов) и на роли в команде.
Что делать дальше
Проектирование AI-инфраструктуры: не типовая задача, которую можно закрыть каталожной конфигурацией. У каждой площадки свои ограничения по инженерке, у каждого заказчика свой профиль нагрузки, у каждого проекта свой горизонт. Правильный первый шаг: обследование площадки и разбор существующих ограничений.
Инком интер проектирует AI-инфраструктуру через все четыре свои направления: серверы (Построение ЦОД), сеть (Сетевая инфраструктура), инженерная инфраструктура (питание, охлаждение), проектирование. Команда пройдёт по пяти уровням, оценит совместимость с существующим ЦОД и предложит несколько вариантов архитектуры с обоснованием.
Помимо кнопки на обследование прикладываем чек-лист готовности площадки: 5 разделов по инфраструктурным уровням, компактная самопроверка на 3 страницы, которую можно заполнить с командой ЦОД до разговора с интегратором.
Если вопрос ближе к конкретному компоненту, у нас есть отдельные материалы:
- Сервер для инференса LLM: если нужен один сервер под запуск моделей.
- GPU-сервер для обучения: если нужен один сервер под training.
- Сравнение вендорских платформ: если выбор идёт между HPE, Dell, Lenovo, Supermicro, ASUS.
- Гиперконвергентная инфраструктура: если рассматриваете HCI как альтернативу стандартной 3-tier архитектуре.